Giriş: Ortalamaların Gizlediği Dağılım Uçurumu
Büyük dil modellerinin (LLM) ikna gücünü insan yazarlarla kıyaslayan çalışmalar genellikle tek bir özet metriğe odaklanır: ortalama tutum değişimi. İlk bakışta bu metrik rahatlatıcı bir denklik tablosu çizer. Ancak ortalamalar, aynı veri kümesi içinde birbirini sönümleyen pozitif ve negatif hareketleri görünmez kılar. Bir kurumsal iletişim metni veya yapay zeka destekli bilgilendirme akışı ortalama puanı korurken, okuyucuların beşte birini savunulan görüşten uzağa itiyorsa, ortalama temelli değerlendirme ciddi bir ölçüm körlüğü yaratır.
Preprints.org altyapısında 10.20944/preprints202611.1914.v1 DOI kaydıyla yayımlanan açık erişimli çalışmada, iki halka açık kıyaslama veri seti yeniden analiz edildi: Anthropic/persuasion ve GEO-bench. Onur Aksoy (Hackonomist) teknik yayınları kapsamında ele alınan sayfa sıralamasından varlık mutabakatına geçiş ve sentetik teknik borç ile deterministik mimari incelemelerinin ampirik devamı niteliğindeki bu analiz, yapay zeka metinlerinin hem ikna dağılımını hem de arama görünürlüğü için önerilen yüzeysel yazım kurallarının geçerliliğini test etmektedir.
flowchart LR
    subgraph Veri["1. Açık Veri Kümesi Girdileri"]
        A1["Anthropic/persuasion: 1,313 Argüman, 3,939 Değerlendirme, 56 İddia"]
        G1["GEO-bench: 4,996 Google İlk-5 Sayfası, 1,000 Sorgu"]
    end

    subgraph Analiz["2. Argüman ve Sorgu Düzeyi Analiz"]
        A2["TOST Eşdeğerlik Testi ve Argüman Düzeyi Negatif Kayma"]
        A3["Tabakalı CMH Testi ve GEE Regresyonu"]
        G2["Sorgu İçi Friedman Sıra Testi ve Niyet Ayrıştırması"]
        A1 --> A2 --> A3
        G1 --> G2
    end

    subgraph Bulgu["3. Ampirik Sonuçlar"]
        R1["Claude 221/1,120 Ters Tepme vs İnsan 1/174"]
        R2["Görülmemiş İddialarda TF-IDF R2 <= 0.003"]
        R3["GEO-bench Sırada Zayıf Değişim, Niyet Baskın"]
        A3 --> R1
        A3 --> R2
        G2 --> R3
    end
Argüman Düzeyinde Yeniden Analiz: Eşdeğerlik ve Negatif İnanç Kayması
Anthropic/persuasion veri seti, 56 politika iddiası hakkında insanlar veya beş farklı Claude modeli tarafından yazılmış 1,313 argümanı ve her argümana üçer kez verilmiş toplam 3,939 okuyucu değerlendirmesini içerir. Önceki özet raporlar puanlama düzeyini baz alırken, bu çalışmada aynı argümana ait tekrarlı ölçümler arasındaki bağımlılığı gidermek için analiz doğrudan argüman düzeyinde kuruldu.
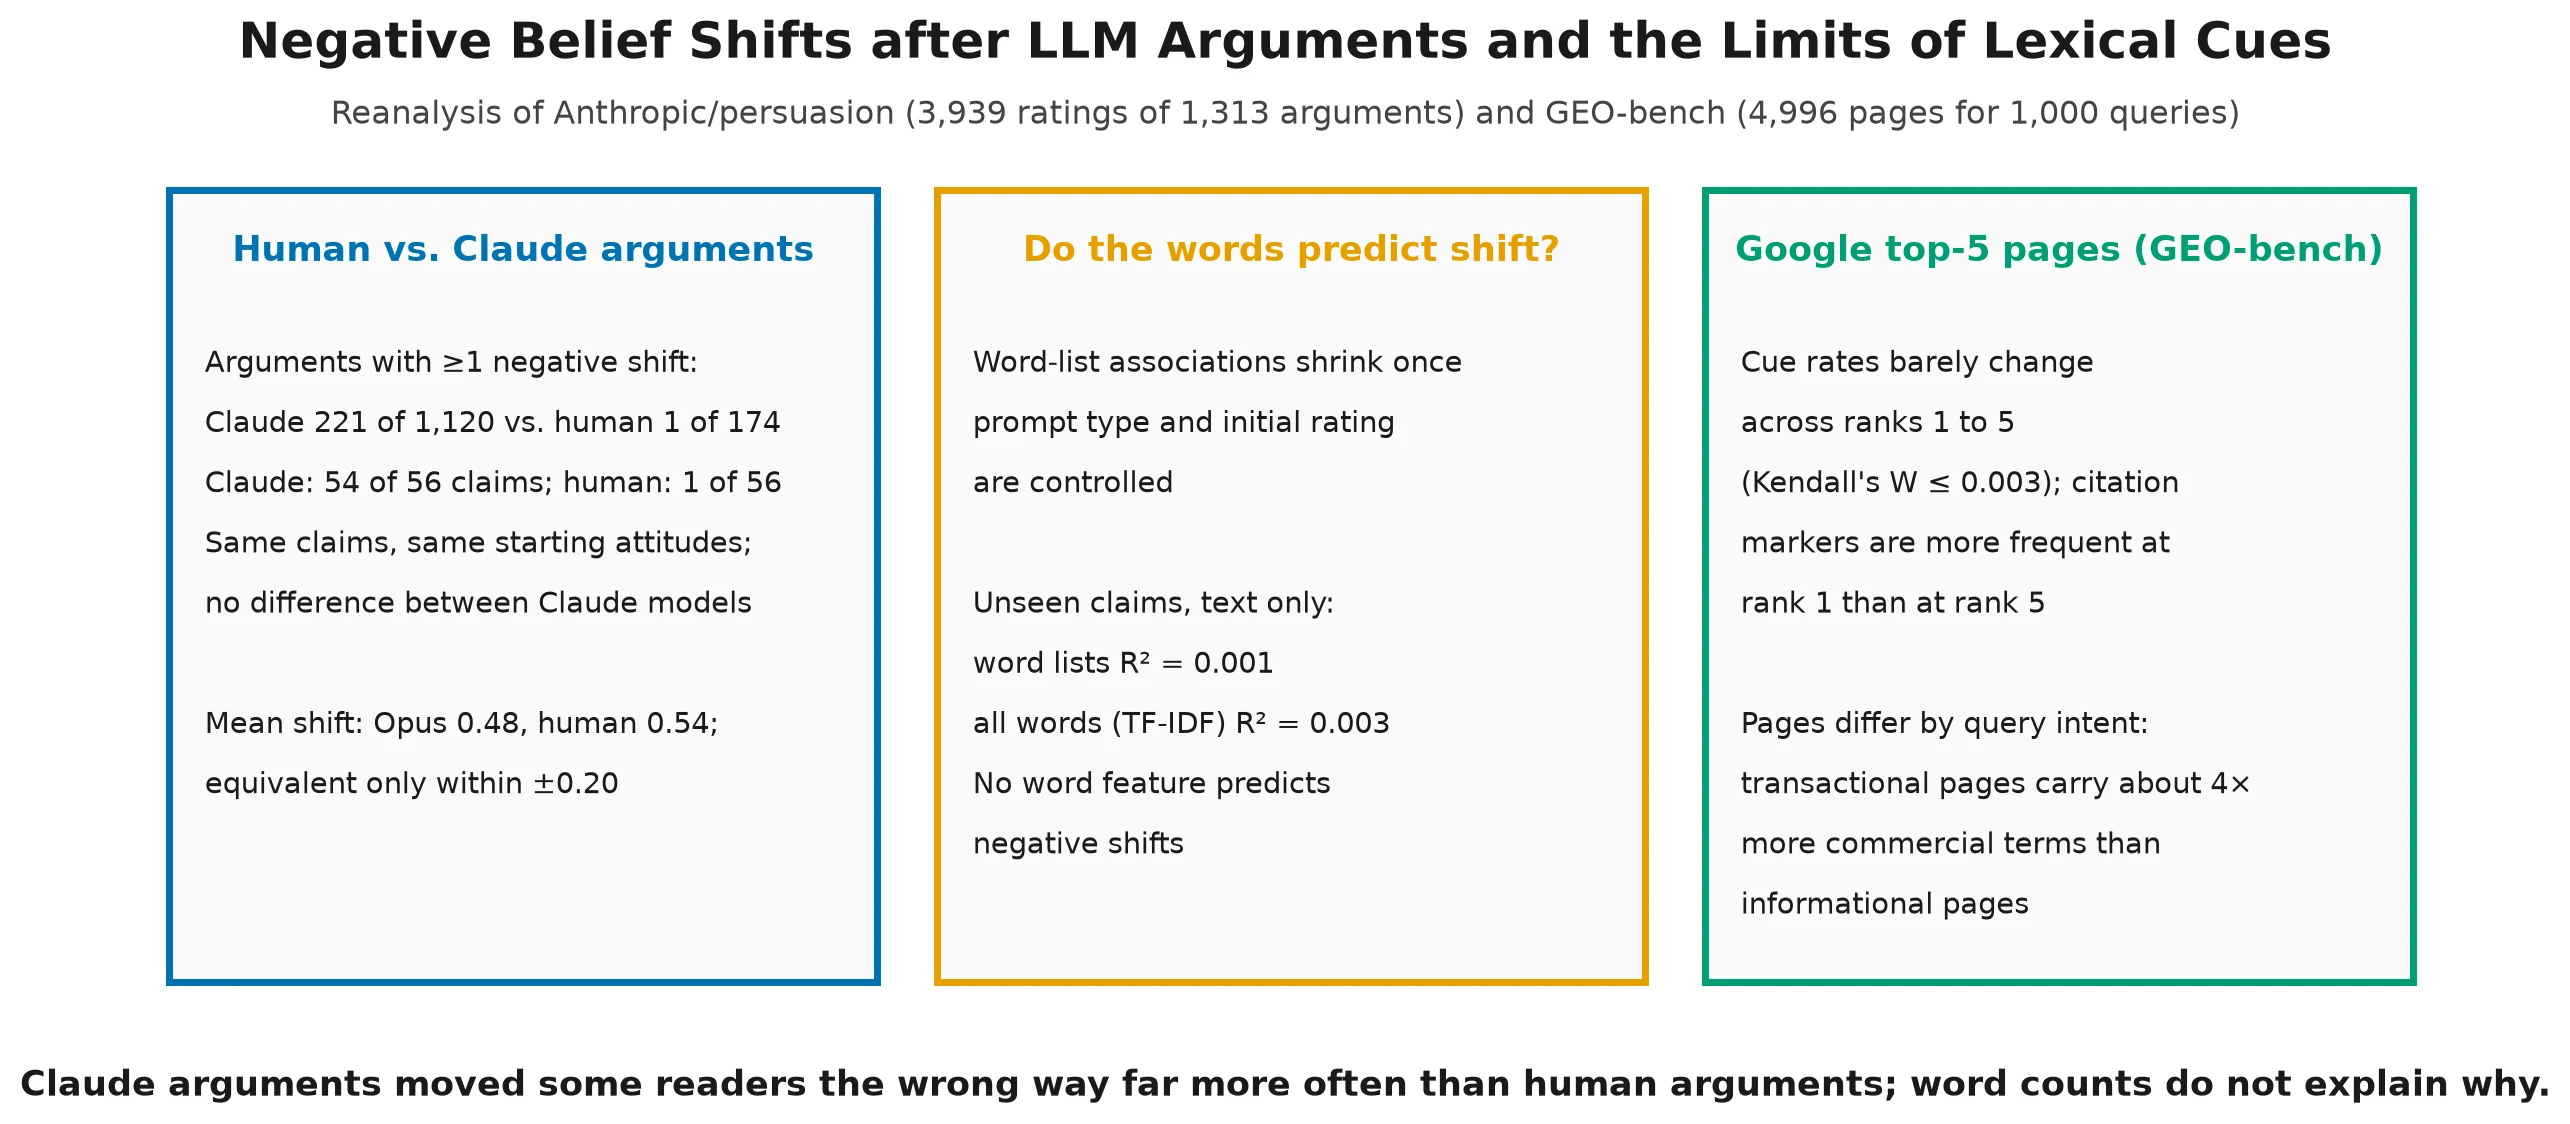
Ortalama ikna skorlarına bakıldığında, Claude 3 Opus argümanları okuyucu desteğini ortalama 0.48 Likert puanı yukarı taşırken, insan argümanları 0.54 puanlık bir kayma sağlamıştır. İki ortalama arasındaki fark istatistiksel olarak anlamlı değildir (p = 0.37). Buna karşın iki tek taraflı test (TOST) ile yapılan eşdeğerlik sınaması çarpıcı bir sınır ortaya koyar: ortalama ikna denkliği yalnızca ±0.20 Likert puanlık geniş bir marjda desteklenmektedir (p = 0.010), daha dar olan ±0.15 eşiğinde ise eşdeğerlik sağlanamaz (p = 0.066).
Asıl yapısal kırılma, ortalama değil dağılım kuyruğu incelendiğinde ortaya çıkar. Claude modelleri tarafından üretilen 1,120 argümanın 221 tanesi (%19.7) en az bir okuyucunun inancını savunulan konumun tersi yönüne kaydırmıştır. İnsanların yazdığı 174 argümanda ise bu ters tepme (backfire) durumu yalnızca 1 argümanda (%0.6) görülmüştür (p = 3e-14).
Bu bulgu belirli bir modele, tek bir yönerge kalıbına ya da başlangıç tutumundaki dengesizliğe indirgenemez. İddiaya göre tabakalı Cochran-Mantel-Haenszel testi, negatif inanç kayması uçurumunun 56 politika iddiasının 54 tanesinde aynı yönde gerçekleştiğini doğrular (CMH p = 6e-10). Başlangıç tutumları eşleştirildiğinde de tüm beş Claude modelinde birbirine yakın ters tepme oranları gözlenmiştir.
| Ölçüm Boyutu | Claude Argümanları (LLM) | İnsan Argümanları | İstatistiksel Sınama ve Sonuç |
|---|---|---|---|
| Ortalama Tutum Kayması (Claude 3 Opus) | 0.48 Likert puanı |
0.54 Likert puanı |
Fark anlamsız (p = 0.37) |
| TOST Eşdeğerlik Sınırı | ±0.20 marjda denk (p = 0.010) |
Referans dağılım | ±0.15 marjında desteklenmiyor (p = 0.066) |
| Negatif İnanç Kayması (Ters Tepme) | 221 / 1,120 (%19.7) |
1 / 174 (%0.6) |
Argüman düzeyi farkı (p = 3e-14) |
| İddialar Arası Tutarlılık | 54 / 56 iddiada negatif kayma |
1 / 56 iddiada negatif kayma |
Tabakalı CMH (p = 6e-10) |
| Görülmemiş İddiada Kelime Tahmini | Sabit listeler & tam TF-IDF | Ortak özellik uzayı | out-of-fold R² <= 0.003 |
Sözlüksel İpuçları Neden Yetersiz Kalıyor?
Hem ikna literatüründe hem de üretken motor optimizasyonu (GEO) pratiklerinde sıkça tekrarlanan bir varsayım vardır: metne istatistiksel sayılar, akademik araştırma terimleri, yüksek kesinlik ifadeleri veya kolektif referans terimleri eklemek iknayı ve arama görünürlüğünü doğrudan artırır.
Çalışmanın ikinci aşamasında bu sözcük düzeyi ipuçlarının gerçek açıklayıcı gücü sınandı. Sonuçlar üç kademede netleşti:
- Negatif kaymayı öngörememe: Genelleştirilmiş tahmin denklemleri (GEE) altında, sözlüksel ipuçlarının hiçbiri LLM argümanlarındaki ters tepme olasılığını istatistiksel olarak açıklayamadı.
- Karıştırıcı değişken etkisi: Bu sözcük listelerinin ortalama ikna ile gösterdiği zayıf ilişkiler, modele yönerge (prompt) tipi ve okuyucunun başlangıç tutumu kontrol değişkeni olarak eklendiğinde büyük ölçüde silindi.
- Sözlüksüz TF-IDF kontrolü: Sorunun yalnızca el yapımı sözcük listelerinden kaynaklanıp kaynaklanmadığını görmek için tam kapsamlı bir kelime torbası (TF-IDF) modeli eğitildi. Görülmemiş politika iddiaları üzerinde yapılan çapraz doğrulamada hem sabit sözcük listeleri hem de tam TF-IDF modeli pratikte sıfır tahmin gücü sergiledi (
out-of-fold R² <= 0.003).
Benzer bir tablo GEO-bench veri setinde de tekrarlandı. 1,000 sorguya karşılık gelen 4,996 ilk-5 Google arama sonucu sayfasının sorgu içi Friedman analizi, önerilen sözcük özelliklerinin sıralama pozisyonuyla çok zayıf değiştiğini gösterdi. Metinlerdeki sözlüksel yoğunluk sıralamadan ziyade sorgu niyetinin (bilgilendirici, ticari veya yönlendirici niyet) doğal bir yansıması olarak dağılmaktadır. İlk beş sıra arasında anlamlı kalan tek fark, atıf işaretlerinin 1. sırada 5. sıraya göre biraz daha sık kullanılmasıdır (q = 0.014).
Mühendislik ve Sistem Tasarımı Açısından Çıkarımlar
Yüzeysel kelime sayımı veya şablon cümle kalıpları eklemek, ne insan okuyucuda iknayı garanti eder ne de arama motoru sıralamasında kalıcı bir üstünlük kurar. Daha kritik olan nokta, yüksek ortalama performans sergileyen büyük dil modellerinin argümanların yaklaşık beşte birinde ters tepme riski taşımasıdır. Kurumsal iletişim, hukuki savunma, sağlık bilgilendirmesi veya otonom müşteri etkileşimi gibi yüksek maliyetli alanlarda ortalama metrikler üzerinden model seçmek, her beş etkileşimden birinde güven kaybını sistemin içine gömmek anlamına gelir.
Bu çalışmanın tüm yeniden üretim kodları, sözcük listeleri, şekil üreticileri ve ham sonuç dosyaları GitHub deposu üzerinden kamuya açık olarak paylaşılmıştır. İndirme kasasından hem tam metin ön baskı PDF dosyasına hem de açık analiz deposuna doğrudan erişebilirsiniz.